Caso de éxito
Evidence-based ATS
Creamos un sistema de seguimiento de candidatos para equipos de selección pequeños, con tres funciones de IA que deben probar lo que dicen antes de que nadie lo vea. Un asistente redacta la ficha de la entrevista a partir de las notas, un cuadro de preguntas responde en lenguaje sencillo sobre el proceso de selección y un resumen describe a cada candidato con frases que citan su fuente. El modelo corre en el propio equipo del reclutador, así que los datos de los candidatos nunca salen de la máquina y ninguna consulta cuesta nada. Cada cita se comprueba palabra por palabra contra su fuente, cada número sale del código y no del modelo, y una persona toma cada decisión de contratación.
- de la evidencia bien archivada
- 82%
- preguntas leídas del todo bien
- 26/26
- preguntas sin respuesta rechazadas
- 6/6
- citas inventadas en una ficha
- 0
El reto
La selección de personal es donde una frase falsa dicha con seguridad hace más daño. Una cita inventada en una ficha de entrevista es una razón inventada para rechazar a alguien, y las normas sobre herramientas de contratación automatizadas no dejan de crecer, de la Local Law 144 de Nueva York a la Ley de IA de la UE y la de Colorado. La mayoría del software de selección añade la IA como un cuadro que responde con aplomo y deja la verificación al lector. El objetivo era una IA que ahorre tiempo real en notas, informes y filtros, sin poner nunca una afirmación sin comprobar delante de quien contrata.
Nuestro enfoque
Empezamos cada función con una sola pregunta: ¿qué tiene que demostrar el modelo antes de que su respuesta llegue a la pantalla? Cuatro reglas rigen todo el producto. El modelo propone y un código sencillo decide qué se muestra. Lo que las comprobaciones descartan sigue en pantalla, tachado y con el motivo por escrito. La persona conserva cada decisión, así que el modelo puede sugerir una nota pero nunca elegirla, y un resumen nunca recomienda. Y el modelo corre en local con Ollama, gratis en cada consulta y del todo opcional, con un modo alternativo que funciona sin él y que indica qué camino produjo lo que se ve. En lugar de una etiqueta vaga de IA, la interfaz dice "Redactado por qwen3.6 en este equipo", para que se sepa con exactitud qué escribió el texto y a dónde fueron los datos.
Fichas redactadas
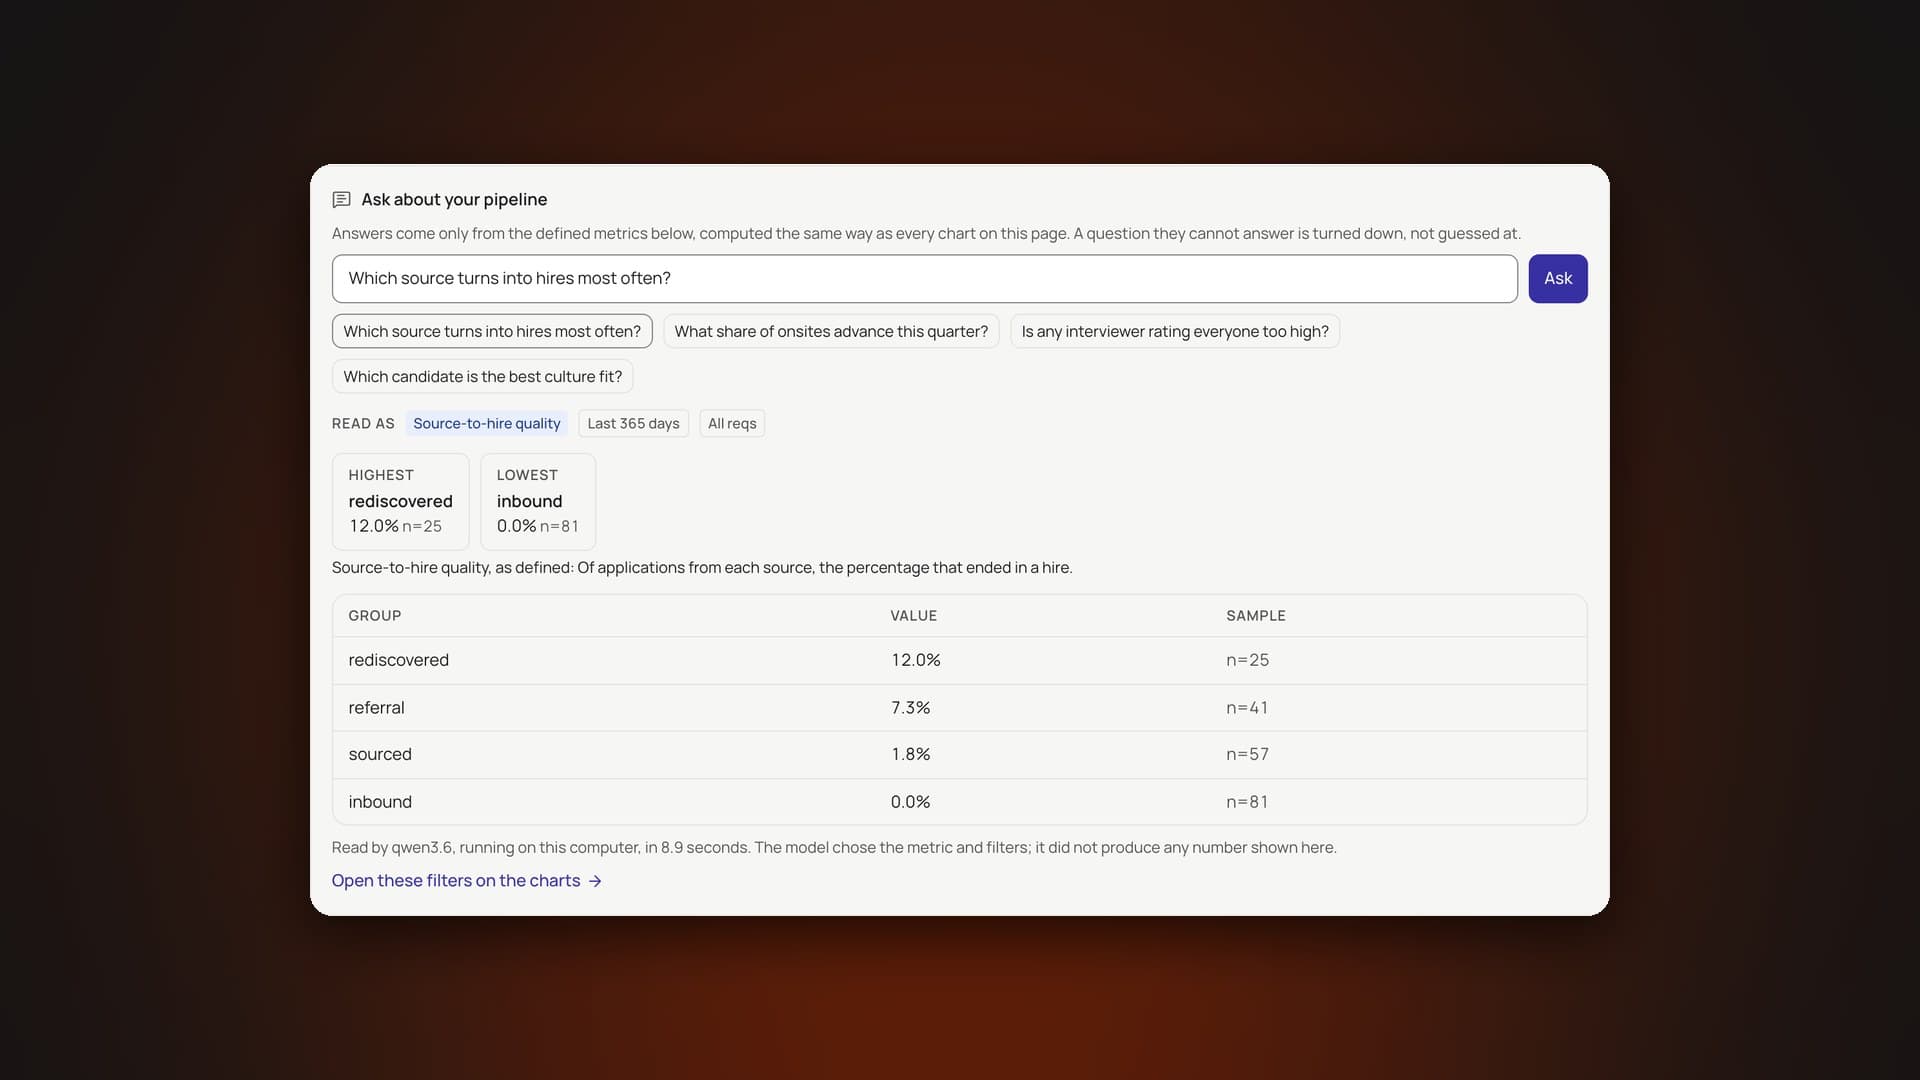
Quien entrevista pega sus notas y el modelo redacta hasta tres citas por atributo, una nota sugerida y una razón de una línea. Un esquema limita al modelo a los atributos de la guía de entrevista, así que no puede inventar uno. Después, cada cita se busca en las notas. La búsqueda perdona cambios de mayúsculas, espacios y comillas, pero no una paráfrasis, y una cita de menos de tres palabras no pasa porque no prueba nada. Las citas sobre rasgos que protege la ley laboral de EE. UU., como la edad, la familia o la salud, se retienen con el motivo a la vista. Una nota sugerida solo se mantiene si la respalda una cita real, y los botones de nota siguen vacíos hasta que la persona elige una.
Preguntas al proceso
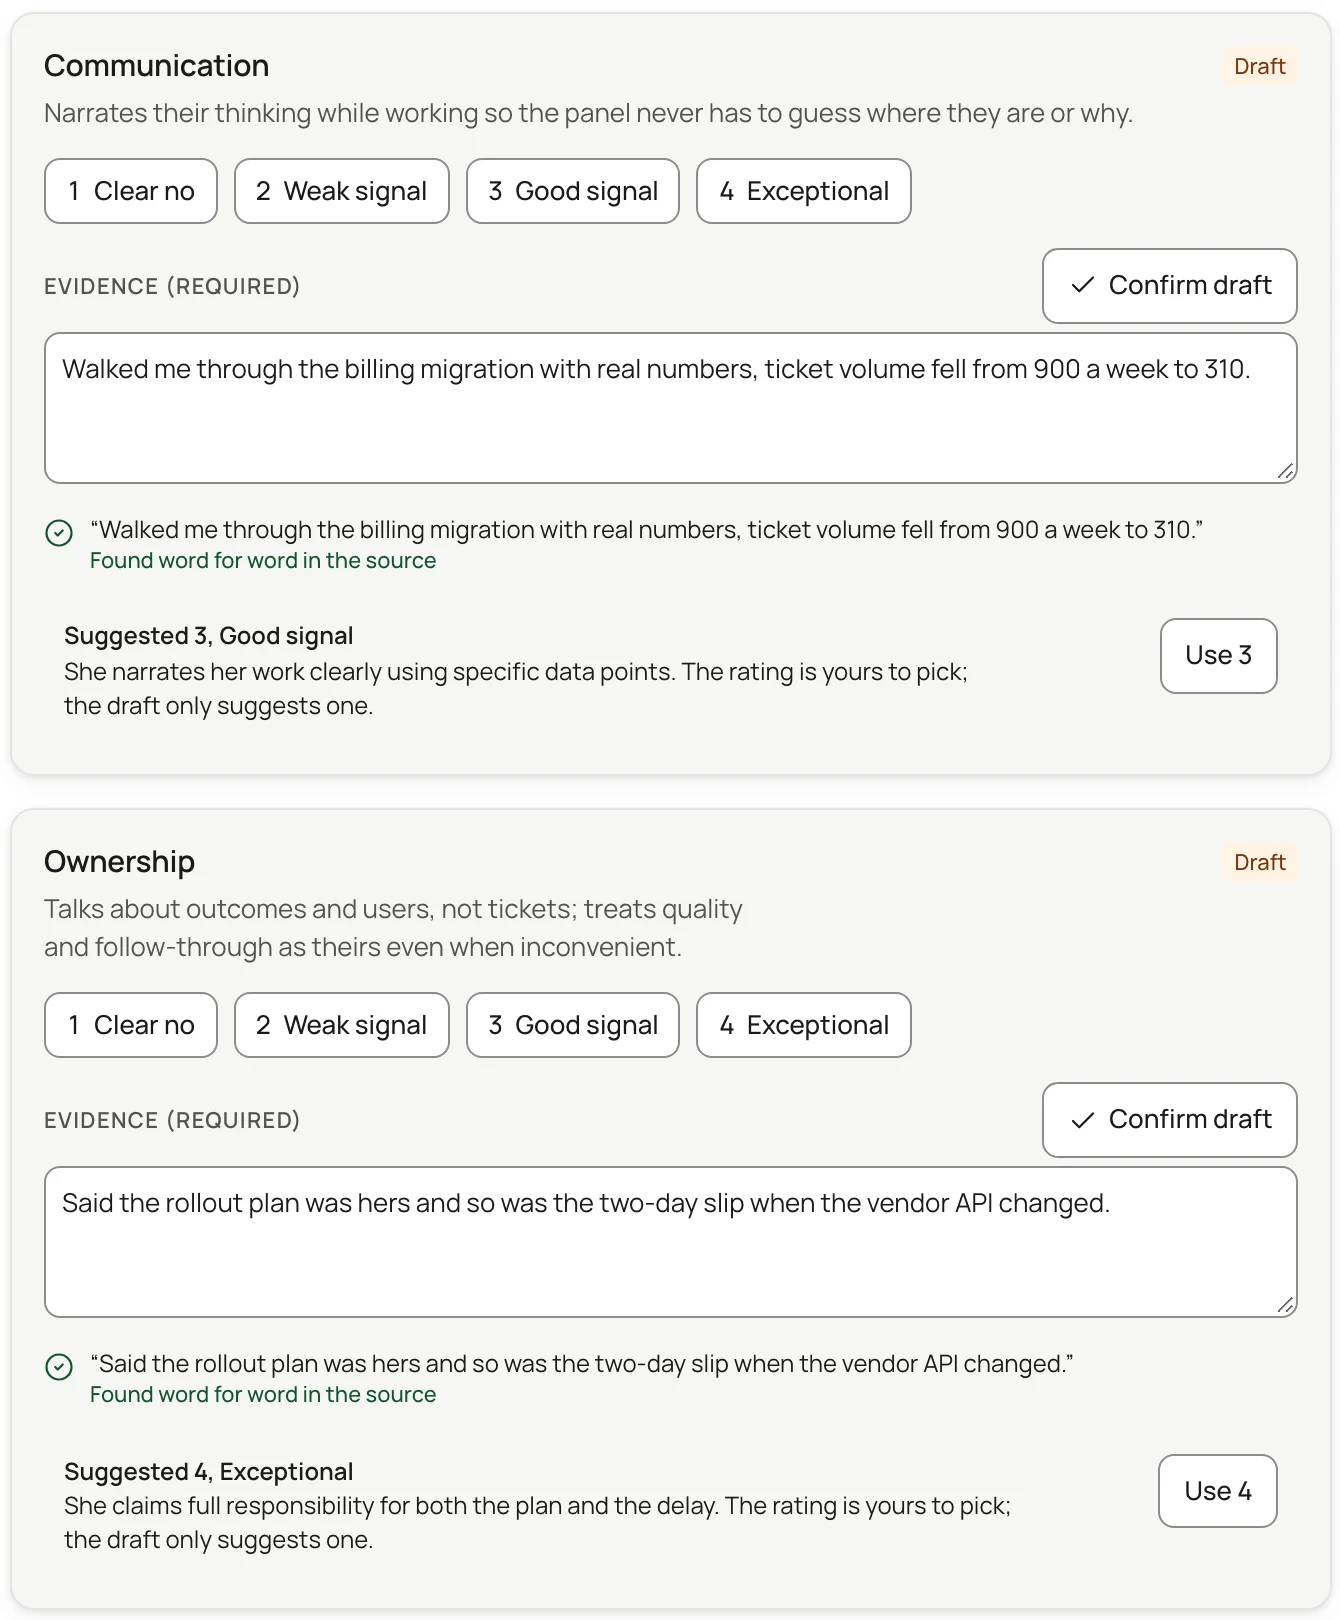
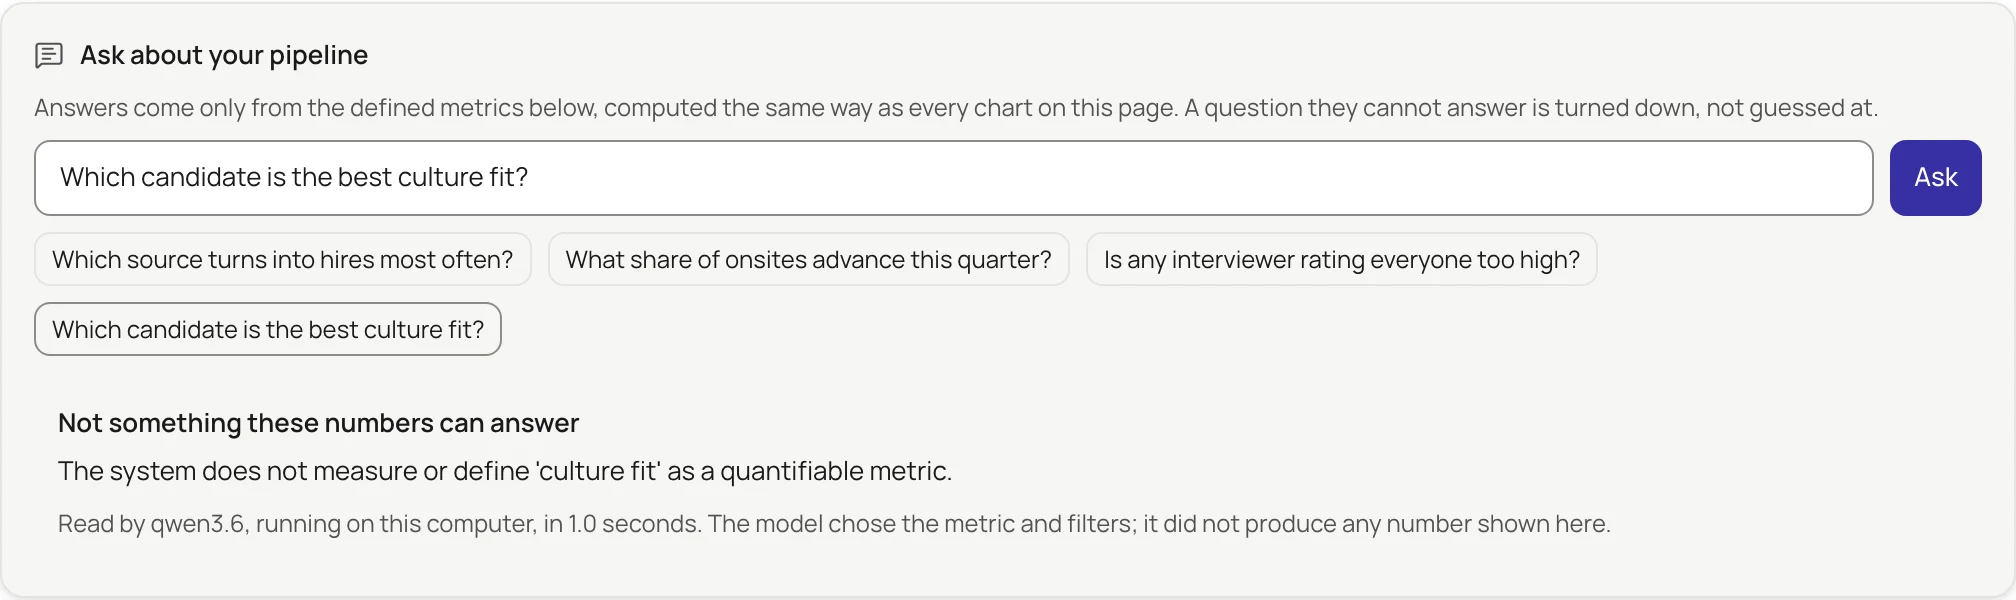
Los reclutadores pueden hacer preguntas sencillas como "¿qué fuente acaba en más contrataciones?". El modelo solo lee la pregunta. Elige una métrica y unos filtros de listas cerradas creadas a partir de los datos reales, y el mismo código que dibuja cada gráfico calcula la respuesta, así que el modelo nunca da un número. Antes de que aparezca una cifra, unas etiquetas muestran cómo se leyó la pregunta: la métrica, el periodo, el puesto y la fuente, para detectar de un vistazo una mala lectura. Las preguntas que ninguna métrica responde, como "¿qué candidato encaja mejor en la cultura?" o "¿qué salario ofrecemos?", se rechazan con un motivo en vez de asignarse a la métrica más parecida.
Resúmenes con fuentes
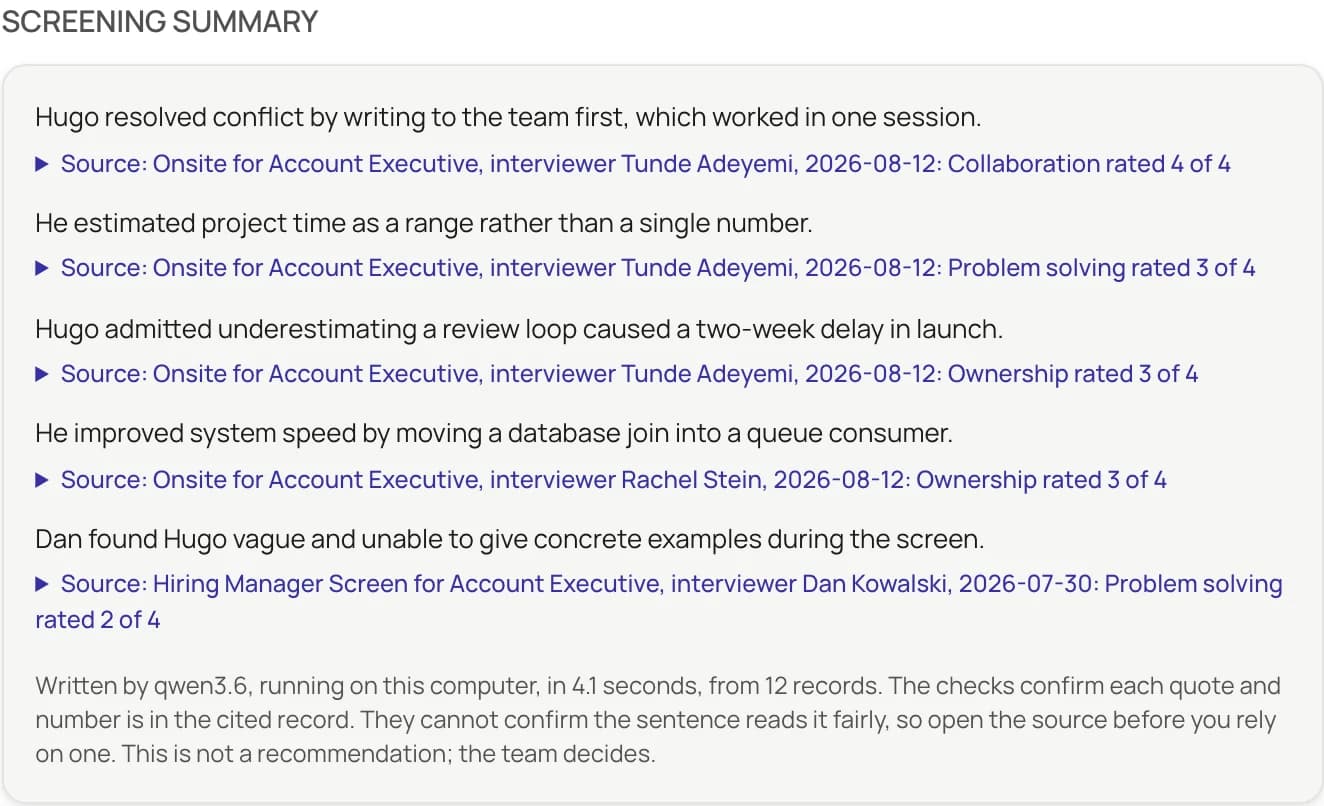
Cuando se le pide, el modelo escribe hasta cinco frases sobre un candidato a partir de sus fichas, las notas del reclutador y los motivos de rechazo, con cada registro numerado y etiquetado. Cada frase debe citar un registro y pasar cuatro comprobaciones: que el registro exista, que la cita esté en él, que cada número aparezca en él y que nada toque un rasgo protegido. Las frases que pasan se abren a su fuente con las palabras citadas resaltadas. Las que no pasan quedan en una lista de "Descartadas tras comprobar" con el motivo. La página también es honesta sobre sus límites: las comprobaciones confirman que las palabras existen, no que la frase las lea con justicia, y lo dice debajo de cada resumen.
El resultado
Un script de evaluación puntúa cada función con casos de prueba fijos, antes y después de las comprobaciones, para que su valor se mida y no solo se afirme. Con el modelo local por defecto, qwen3.6, el asistente colocó el 82% de la evidencia etiquetada en el atributo correcto, frente al 30% de una búsqueda por palabras clave, y ninguna cita inventada o sobre rasgos protegidos llegó a la ficha. Leyó del todo bien las 26 preguntas sobre el proceso, incluidas las 6 que debía rechazar. El 98% de las frases de los resúmenes pasó todas las comprobaciones, y la única que falló quedó retenida. También funciona un modelo más pequeño de 2 GB, y la evaluación muestra con claridad dónde se queda corto: añade filtros que nadie pidió, justo el error que las etiquetas de lectura de cada pregunta existen para detectar.
Tecnología y despliegue
El sistema usa Next.js 15, React 19 y TypeScript, con SQLite para los datos y Tailwind CSS para los estilos. Funciona como aplicación web o como aplicación de escritorio para Mac hecha con Tauri. Los modelos corren con Ollama en el mismo equipo, con qwen3.6 por defecto y llama3.2 como opción más ligera, y un solo ajuste apaga el modelo por completo. Las cifras del embudo y de paso entre etapas salen de un registro de eventos de cada cambio de etapa y no del estado actual, así que los informes nunca cambian a posteriori. La interfaz se auditó según WCAG 2.2 AA, y su combinación de texto más débil tiene un contraste de 7,22 a 1.